


AI解码生命 统计赋能前沿丨第二届统计文化节科普报告精彩开讲
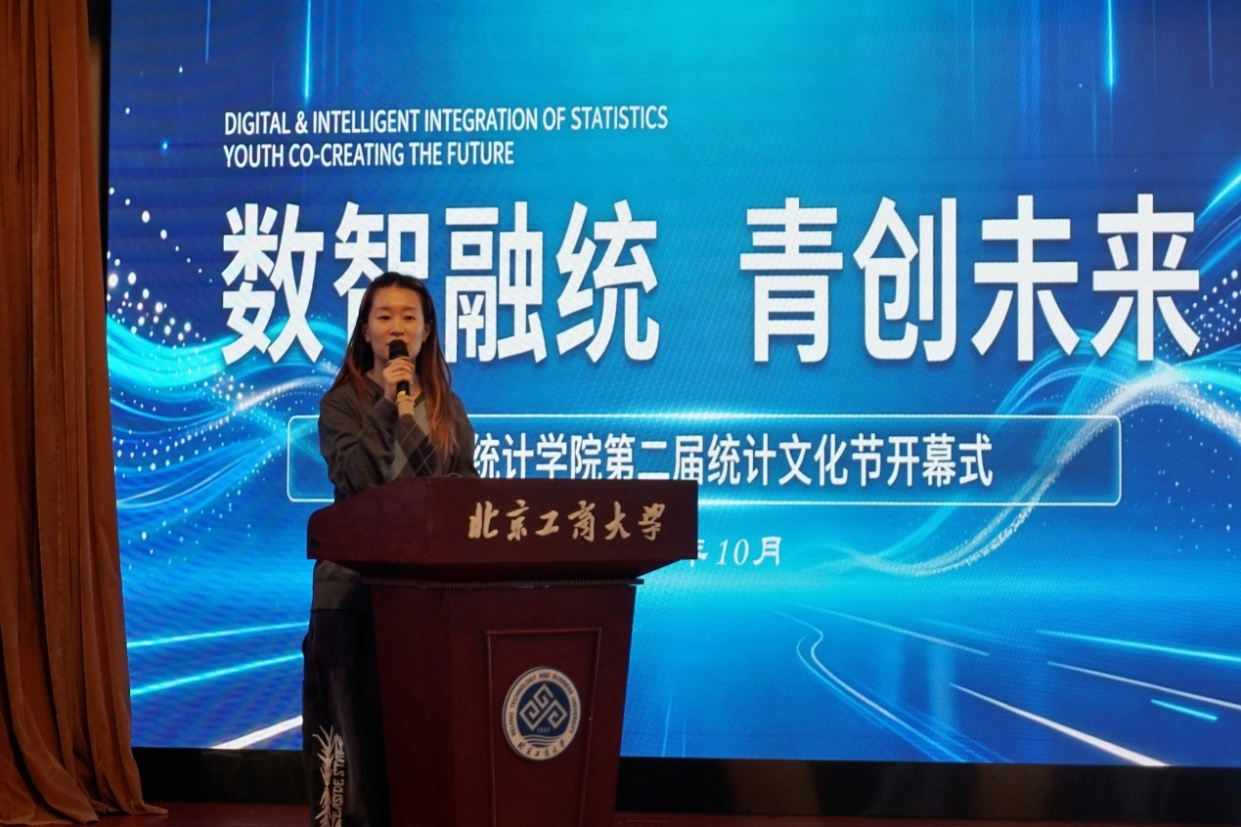
10月21日,数学与统计学院第二届统计文化节顺利开幕。数据科学系教师翟雨瑶带来题为《AI能读懂生命吗?从高维统计到单细胞基础模型——一场关于数据、预测与生命规律的探索》的科普报告,为在场师生带来了一场统计学、人工智能与生命科学深度交叉的前沿知识科普。
报告开篇,翟雨瑶老师抛出引人深思的问题:“如果把AI处理的对象从语言换成人体细胞,它还能学到什么?”,迅速抓住在场所有同学的注意力。整场分享没有堆砌晦涩的公式与生硬的专业名词,她配合直观的单细胞图谱、清晰的测序流程图示,一步步将复杂的生命系统运行逻辑与统计学习框架拆解开来,带领在场师生开启了一场跨学科的探索之旅。
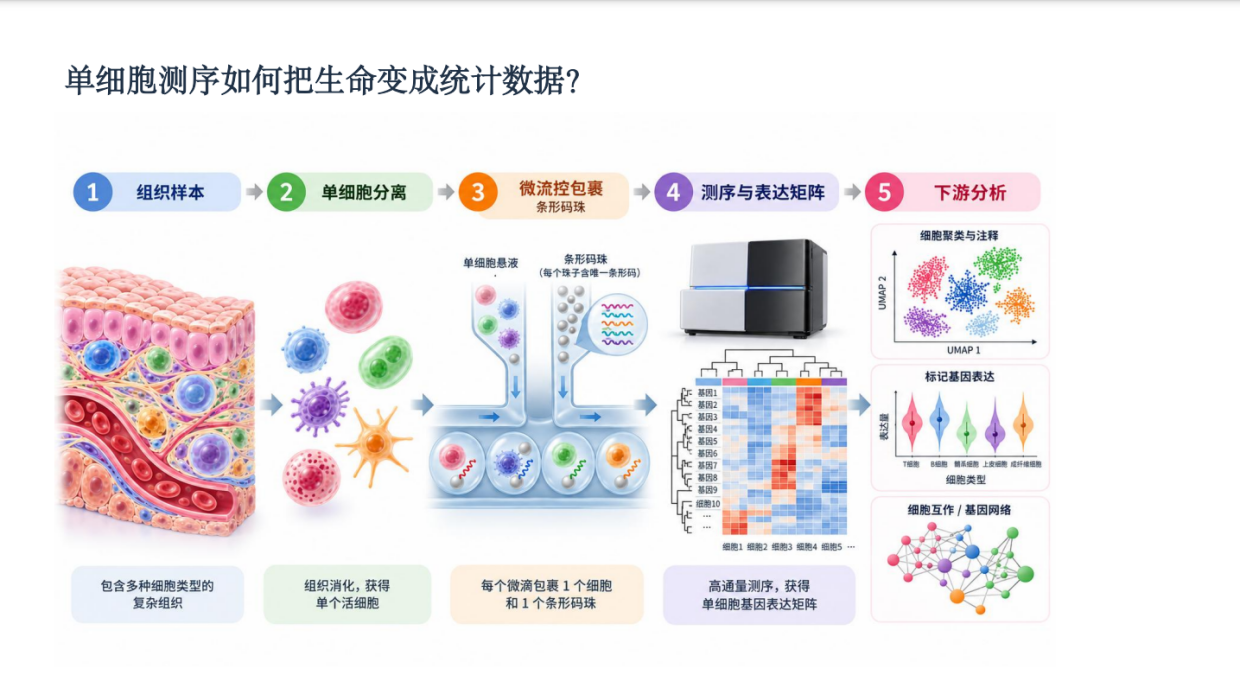
报告从单细胞测序技术切入,逐层拆解前沿研究背后的核心统计学问题。她指出,人体细胞生命特征转化为海量基因表达矩阵后,即便遗传背景一致,不同测序平台、测序深度和实验批次仍会在数据中引入系统性技术差异,即“批次效应”。针对单细胞基因表达矩阵降维中常用的主成分分析(PCA),她提醒,常规追求的“最大方差”方向未必承载真正的生物规律,反而可能混入测序深度、细胞周期等噪声。
PCA的这一局限也引出了更一般的表征学习问题。围绕如何在降噪的同时保留细胞间真实生物差异,她对比了单细胞建模中传统的“重建式学习”与前沿的“潜在表征预测”JEPA范式:前者直接预测原始基因表达值,易受数据稀疏计数和技术噪声影响;后者转向预测目标基因的高维表征,更关注跨基因整体信息结构,对技术噪声的鲁棒性显著更强,但容易出现“表征坍塌”的问题。两者并非绝对优劣,而是建模假设与适用任务不同:重建式学习侧重表达空间的信息恢复,JEPA类方法侧重潜空间中的可预测结构。
针对“表征坍塌”的难点,翟雨瑶作出通俗解读:若模型将不同类型细胞映射为相同向量,就会丧失区分细胞异质性的能力,后续生物医学分析也将失去意义。因此,JEPA范式在训练流程中加入分布约束,从根源上规避表征坍塌,既保证预测性能,又保留细胞间真实生物差异。她还以scJEPA的实验结果为例,展示了该模型在细胞精细分类、跨批次数据整合、关键基因影响效应排序等下游任务中的表现,展现统计建模在精准医疗中的应用潜力。
报告尾声,翟雨瑶着重强调“数据相关不等于因果”。她举例说明,基因A与基因B表达显著正相关,并不能直接得出“A导致B”的结论,背后可能有细胞类型、上游信号通路等共同原因C同时影响二者。想要确认真实因果效应,需借助基因扰动随机实验(如Perturb-seq)、孟德尔随机化等因果推断方法逐步验证。因此,模型给出的基因排序更适合用于提出假设和确定实验优先级,而不能直接等同于基因敲除的因果效应。
整场报告以清晰逻辑和前沿案例阐释了统计学在AI与生命科学交叉领域的核心价值。在场同学纷纷表示,此次分享刷新了对统计学应用边界的认知:统计学不止于公式计算和模型结果,更在于保持思辨,追问“模型到底学到了什么,还有什么尚未真正理解”。这也与本届统计文化节的核心理念相契合,引导同学们了解交叉学科前沿,以严谨思辨的专业视角挖掘海量数据背后的客观规律。
文字丨黄予之
图片丨洪嘉睿 魏新和 刘一
编辑丨王赵懿宣
审核丨翟雨瑶 寇明雯 魏畅 辛一丹
审定丨毕平平
-
2026-10-23 数学与统计学院举办 “数智融统·青创未来”第二届统计文化节开幕式
-
2026-10-21 我院统计学博士生郭喜辰在国际权威期刊JMLR发表研究论文
-
2026-09-11 数学与统计学院召开2026年秋季学期全体教职工大会
-
2026-08-31 华侨大学数学科学学院到数学与统计学院交流调研
-
2026-08-27 喜报!我院国家自然科学基金项目取得历史性突破
-
2026-07-19 深化多方联动,赋能育人就业双提升|数学与统计学院顺利召开校企协专项座谈会
-
2026-11-04 AI解码生命 统计赋能前沿丨第二届统计文化节科普报告精彩开讲
-
2026-11-03 凝秋聚力 趣暖研途|我院研究生积极参与学校第七届研究生趣味运动会✨
-
2026-10-28 职涯规划·保研篇Ι蔡欣辰:踏实积累,静待花开
-
2026-10-31 志愿护平安 青春显担当|智汇雅苑社区地铁执勤志愿服务活动圆满开展
-
2026-11-02 “京”彩文化 青春绽放 数统学子赴一场跨越时空的“红色长征”
-
2026-10-30 职涯规划·保研篇Ι方琪:如我自观,如涉千山,如我所是,如我所愿
-
2026-10-29 拼出心情,“豆”留快乐——学院二级心理辅导站举办解压手工拼豆活动
-
2026-10-29 数绘万象·统艺流光|舞台已就绪,期待与你共赴流光之夜
-
2026-10-28 2026-2027-1学期 校定必修课期中考试考场安排-数学四门公共课
-
2026-10-23 关于举办第四届全国大学生职业规划大赛 北京工商大学校赛工作的通知
-
2026-10-20 关于2026年第十八届全国大学生数学竞赛的第二轮通知 ——准考证打印及考试相关事项
-
2026-10-16 【公示】数学与统计学院2025-2026学年本科生学业奖学金、荣誉称号公示
-
2026-10-08 【公示】数学与统计学院2026推荐研究生奖励名单公示
-
2026-10-08 第十六届北京工商大学“立丰杯”市场调查与分析大赛征文及宣讲会通知
-
2026-09-28 数学与统计学院2026年本科生国家奖学金推荐名单公示
-
2026-09-28 数学与统计学院2026年研究生国家奖学金推荐名单公示